هل يفهم ChatGPT وGemini اللهجة المصرية والخليجية فعلًا؟
4 نوفمبر، 2026 ·
دليل AI • تقرير بحثي • 4 نوفمبر 2026
فهم المعنى أم تقليد اللهجة؟ اختبر الفرق بنفسك
خريطة المقال — اختر ما يهمك
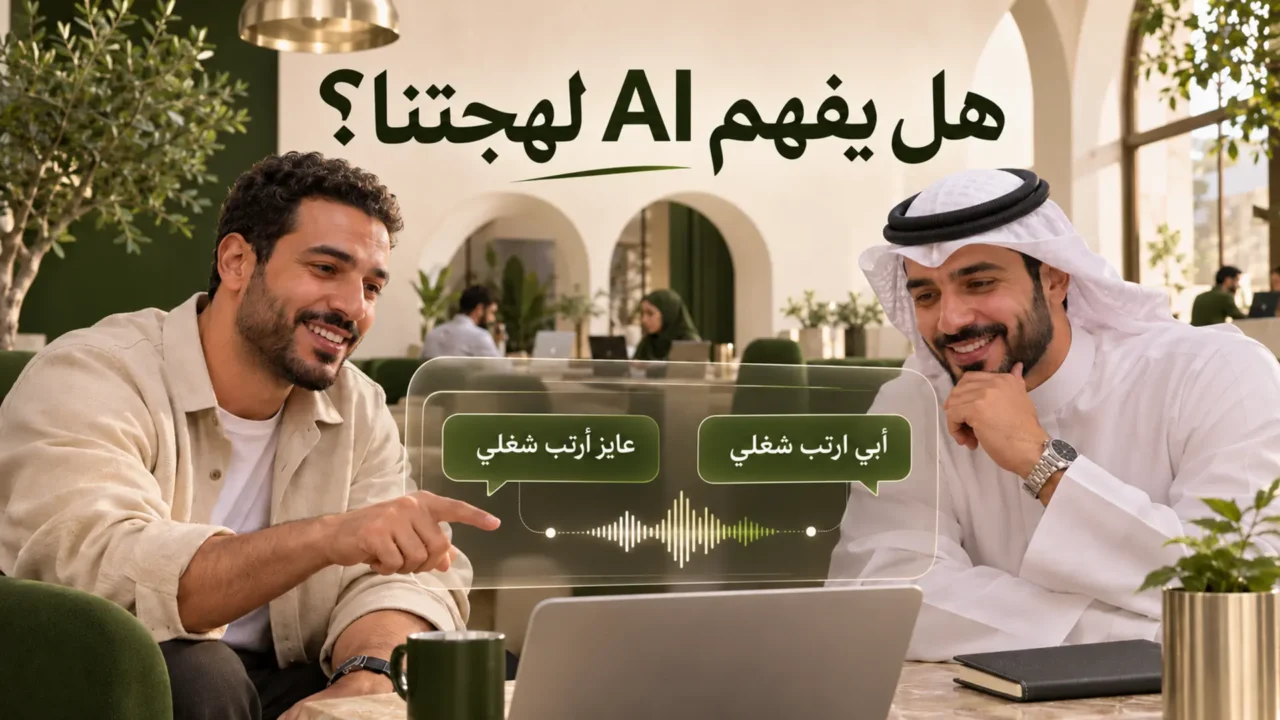
«عايز أظبط شغل المحل، والطلبات متتأخرش على الزباين». «أبي أضبط طلبات المتجر، وما ودي العملاء يتأخر عليهم التوصيل». الجملتان تعبران عن احتياج متقارب، لكنهما مكتوبتان بطريقتين مختلفتين. الأولى باللهجة المصرية، والثانية بلهجة خليجية قريبة من الاستخدام السعودي. بالنسبة إلى الإنسان المعتاد على اللهجتين، لا تبدو المهمة صعبة، لكن كيف يفهمها الذكاء الاصطناعي؟ وهل يستطيع تفسير العبارات المحلية وتحويلها إلى خطة عمل مناسبة دون تغيير المقصود؟
مع الانتشار الواسع لمساعدات مثل ChatGPT وGoogle Gemini وظهور نماذج عربية متخصصة، أصبح التفاعل باللغة العربية أسهل من السابق. ومع ذلك، فإن قدرة النموذج على الرد بالعربية لا تكفي لإثبات أنه يفهم اللهجات المحلية بالدرجة نفسها. تكشف أبحاث علمية منشورة خلال عامي 2025 و2026 أن التحدي لم يعد مقتصرًا على الترجمة بين العربية والإنجليزية، بل أصبح مرتبطًا بفهم المعاني الضمنية والتعبيرات اليومية والفروق الثقافية بين المجتمعات العربية.
في هذا التقرير، نوضح ما توصلت إليه الأبحاث، ونقارن بين طبيعة التحديات في اللهجتين المصرية والخليجية، ونقدم منهجًا عمليًا يستطيع القارئ استخدامه لاختبار أي مساعد ذكاء اصطناعي قبل الاعتماد عليه في الدراسة أو صناعة المحتوى أو خدمة العملاء.
أولًا: هل دعم اللغة العربية يعني فهم جميع لهجاتها؟
عندما تعلن شركة تقنية أن نموذجها يدعم العربية، فقد يشير ذلك إلى قدرته على قراءة نصوص عربية والرد عليها، أو إلى توفر واجهة مستخدم باللغة العربية، أو إلى دعم مجموعة محددة من المهام اللغوية. لكن هذه المستويات تختلف عن القدرة على فهم الكلام اليومي باللهجات المحلية. فالعربية الفصحى المستخدمة في الأخبار والمستندات تختلف عن اللغة التي يتحدث بها الناس في الأسواق والمنازل ومواقع التواصل الاجتماعي.
وقد تحتوي الجملة الواحدة على كلمات محلية، واختصارات إنجليزية، وتعبيرات مجازية، وأسماء منتجات، ومصطلحات مهنية تختلف من دولة لأخرى. ولهذا لا يمكن افتراض أن النموذج الذي يكتب تقريرًا بالفصحى يستطيع تلقائيًا تفسير كل عبارة مصرية أو سعودية أو إماراتية أو كويتية بصورة صحيحة. وتشير الأبحاث الحديثة إلى أن مستوى الأداء قد يتغير بحسب اللهجة ونوع المهمة والمجال المعرفي، حتى عندما يكون النموذج نفسه قادرًا على التعامل مع العربية بصورة عامة.
ثانيًا: ماذا تقول أحدث الأبحاث عن فهم اللهجات العربية؟
دراسة 2026: اختبار 15 ألف سؤال بخمس لهجات
في مايو 2026، نُشرت دراسة علمية بعنوان DialectalArabicMMLU ضمن مؤتمر LREC 2026، بهدف قياس قدرة النماذج اللغوية على التعامل مع أسئلة معرفية ومهنية باللهجات العربية. اعتمد الباحثون على 3 آلاف سؤال وجواب جرى تكييفها يدويًا إلى خمس لهجات رئيسية:
- المصرية.
- السعودية.
- الإماراتية.
- السورية.
- المغربية.
وأنتج هذا العمل 15 ألف زوج من الأسئلة والإجابات باللهجات الخمس، تغطي 32 مجالًا أكاديميًا ومهنيًا. واختبرت الدراسة 19 نموذجًا مفتوح الأوزان، تشمل نماذج عربية ومتعددة اللغات تتراوح أحجامها بين مليار و13 مليار معامل. وأظهرت النتائج فروقًا ملحوظة في الأداء بين اللهجات، مع استمرار تحديات في تعميم القدرات اللغوية من العربية الفصحى إلى الكلام المحلي. ماذا نستنتج؟ أن نجاح نموذج في الإجابة عن سؤال بالفصحى لا يضمن نجاحه في الإجابة عن السؤال نفسه عندما يُصاغ باللهجة المصرية أو السعودية.
لكن الدراسة لا تتيح وحدها إصدار حكم مباشر بأن أحدث إصدار من ChatGPT أو Gemini أفضل من الآخر؛ لأنها اختبرت مجموعة محددة من النماذج المفتوحة ووفق منهجية معينة.
دراسة أكتوبر 2026: فهم المعنى لا يساوي إتقان اللهجة
تقدم دراسة أحدث بعنوان EDRAC: Benchmarking Arabic Dialect Reading Comprehension زاوية مهمة للمقارنة. تضمن معيار EDRAC نحو 499 مقطعًا مستمدًا من تفاعلات منطوقة طبيعية، و4,977 زوجًا من الأسئلة والأجوبة، عبر اللهجات المصرية والسعودية والإماراتية والسورية والمغربية. وأظهرت نتائج الدراسة وجود فجوة بين جودة الإجابة من حيث المعنى، ومدى التزامها الفعلي باللهجة المطلوبة. وهذا يعني أن النموذج قد يفهم السؤال ويقدم إجابة صحيحة، لكنه يستخدم تعبيرات لا تنتمي إلى لهجة المتحدث، أو يخلط بين الفصحى واللهجات المختلفة.
وبالنسبة إلى المستخدم العادي، قد لا تمثل هذه المشكلة عائقًا كبيرًا عندما يريد معلومة مباشرة. لكنها تصبح أكثر أهمية عند إعداد إعلان محلي أو كتابة سيناريو أو تشغيل وكيل لخدمة العملاء يتحدث باسم شركة داخل دولة عربية معينة.
ثالثًا: لماذا تواجه النماذج صعوبة في فهم اللهجة المصرية؟
تتميز اللهجة المصرية بانتشارها الواسع في الإعلام والمحتوى المرئي، لكنها تحتوي أيضًا على تراكيب لغوية وتعبيرات اجتماعية لا يكفي فهم كلماتها منفصلة للوصول إلى المقصود. خذ المثال التالي: «العميل بيقول إنه هيعدي علينا آخر النهار، بس مش عايز يستنى كتير». المعنى المطلوب ليس شرح الكلمات، بل فهم أن العميل ينوي الحضور إلى مكان العمل في وقت لاحق، وأنه يحتاج إلى خدمة سريعة تقلل وقت الانتظار.
إذا فسّر النموذج عبارة «هيعدي علينا» باعتبارها مجرد المرور بالقرب من المكان، فقد يفقد جزءًا مهمًا من نية العميل. وهناك مشكلة أخرى تتعلق بالتعبيرات التي تعتمد على سياق الحديث. فعبارة مثل «الشغل واقف» قد تشير إلى ضعف المبيعات أو توقف الإنتاج أو تعطّل إجراءات معينة، بحسب طبيعة النشاط. والنموذج الموثوق لا ينبغي أن يختار تفسيرًا واحدًا بثقة زائدة عندما لا توجد معلومات كافية؛ بل قد يكون الأفضل أن يسأل عن المقصود أو يقدم الاحتمالات الأقرب.
رابعًا: وماذا عن اللهجات الخليجية؟
من الأخطاء الشائعة التعامل مع اللهجة الخليجية باعتبارها لهجة واحدة متطابقة في السعودية والإمارات والكويت وقطر والبحرين وعُمان. هناك عناصر لغوية مشتركة، لكن توجد أيضًا اختلافات مهمة في المفردات والنطق والاستخدامات الاجتماعية والمهنية، بل وفي اللهجات داخل الدولة الواحدة. على سبيل المثال، قد يقول عميل سعودي: «أبي أعرف إذا الطلب جاهز، ولا باقي عليه؟» ويكون المطلوب من وكيل خدمة العملاء تحديد حالة الطلب والمدة المتبقية بصورة واضحة.
أما إذا أجاب النظام برد عام عن أهمية سرعة الشحن أو مزايا المتجر، فسيكون قد فشل في فهم النية العملية رغم قدرته على كتابة كلمات خليجية. والأهم أن بعض التعبيرات لا تنقل معناها بالكامل عند استبدال الكلمات المحلية بكلمات فصحى. فكتابة محتوى تسويقي لجمهور سعودي تختلف عن كتابة نسخة موجهة إلى الجمهور الإماراتي، حتى عندما يكون المنتج نفسه. ولهذا فإن اختبار دعم العربية يجب أن يشمل الجمهور المستهدف تحديدًا، وليس الاكتفاء بتسمية عامة مثل «اللهجة الخليجية».
خامسًا: فهم اللهجة أم تقليد اللهجة.. ما الفرق؟
هذه واحدة من أهم النقاط التي يجب الانتباه إليها عند تقييم أي نموذج. قد يستطيع المساعد كتابة رد يبدو مصريًا بإضافة كلمات مثل «عايز» و«دلوقتي»، أو صياغة رد خليجي باستخدام «أبي» و«وش». لكن هذا لا يثبت أنه فهم السؤال. يمكن تقسيم التقييم إلى أربعة مستويات:
| مستوى الاختبار | ما الذي نقيسه؟ | مثال |
|---|---|---|
| فهم المعنى | تفسير الطلب بصورة صحيحة | فهم شكوى العميل |
| فهم السياق | معرفة المقصود وفق الموقف | تفسير عبارة محلية تحتمل أكثر من معنى |
| سلامة اللهجة | اختيار تعبيرات مناسبة للجمهور | الرد باللهجة المصرية أو السعودية |
| تنفيذ المهمة | تقديم حل عملي دون فقدان التفاصيل | إعداد رد مناسب وخطوة متابعة |
ومن الممكن أن ينجح النموذج في مستوى ويفشل في آخر. فقد يفهم شكوى العميل لكنه يرد بالفصحى، أو يقدم لهجة طبيعية لكنه يخترع موعدًا للتوصيل لم يُذكر أصلًا. ولهذا لا يكفي تقييم شكل اللغة؛ بل يجب فحص صحة المعنى والنتيجة العملية.
سادسًا: هل النماذج العربية المتخصصة أفضل من النماذج العالمية؟
تقدم دراسة AraDiCE المنشورة في مؤتمر COLING 2025 منظورًا مهمًا لهذه المسألة. طوّر الباحثون معيارًا لتقييم القدرات اللغوية والثقافية في اللهجات العربية، وقدموا نحو 45 ألف عينة خضعت للتحرير البشري، ضمن مجموعة من المهام المرتبطة بالفهم والتوليد والترجمة والوعي الثقافي. وأظهرت نتائج الدراسة أن بعض النماذج العربية المتخصصة، ومنها Jais وAceGPT، تفوقت على نماذج متعددة اللغات في مهام لهجية معينة.
لكن هذه النتيجة لا تعني أن النماذج العربية تتفوق دائمًا على أحدث النماذج العالمية، ولا أنها أفضل في البرمجة أو الاستدلال أو جميع أشكال المحادثة. فالنتائج ترتبط بالنماذج التي اختبرتها الدراسة، وبالبيانات والمهام المستخدمة، وبتاريخ إجراء التقييم. كما أن نموذجًا عالميًا أحدث قد يقدم أداءً مختلفًا تمامًا عن إصدار قديم من العائلة نفسها. الأهم للمستخدم هو اختبار المنتج المتاح له الآن، على نوع المحتوى الذي سيستخدمه فعلًا، بدل الاختيار اعتمادًا على بلد تطوير النموذج وحده.
سابعًا: لماذا تعد الثقافة المحلية جزءًا من فهم اللغة؟
من السهل تقييم بعض المهام من خلال مقارنة الإجابة بنص مرجعي، لكن فهم الثقافة أصعب من ذلك. فالرد المناسب على دعوة اجتماعية، أو رسالة اعتذار، أو شكوى من عميل، قد يعتمد على درجة الرسمية والعلاقة بين الأشخاص وطبيعة المجتمع. وقد تكون العبارة صحيحة لغويًا لكنها غير مناسبة في سياقها الاجتماعي. وتتناول أبحاث مثل AraDiCE هذا الجانب من خلال اختبارات مخصصة للوعي الثقافي في مناطق عربية، تشمل الخليج ومصر وبلاد الشام.
لكن قياس الوعي الثقافي نفسه يحتاج إلى الحذر، لأن المجتمعات لا يمكن اختزالها في مجموعة ثابتة من العبارات أو العادات. والأفضل أن يتعامل الذكاء الاصطناعي مع اللغة المحلية بوصفها سياقًا يجب فهمه، لا مجرد قائمة من الكلمات التي يضيفها إلى الرد.
ثامنًا: اختبار AI-Dalil المقترح للهجتين المصرية والخليجية
حتى لا نعتمد على الانطباعات الشخصية، أعددنا إطار تقييم تحريريًا يمكن تطبيقه على ChatGPT وGemini والنماذج العربية المتخصصة. مهم: الاختبارات التالية من تصميم AI-Dalil كنموذج تقييم مقترح، ولم تُنسب إليها نتائج أداء فعلية لأي نموذج حتى الآن.
الاختبار الأول: فهم الطلب المصري
نص الاختبار: «عندي محل موبايلات، والطلبات متأخرة، والزبون كل شوية يكلمني يسأل الطلب فين. عايز أظبط الدنيا من غير ما أزوّد العمالة». المطلوب من النموذج: تحديد المشكلة، واقتراح ثلاث خطوات عملية، وكتابة رد قصير مناسب للعميل باللهجة المصرية. ما الذي نبحث عنه؟ يجب أن يفهم النموذج أن المشكلة تتعلق بإدارة الطلبات والتواصل مع العملاء، وليس فقط بنقص عدد الموظفين. كما ينبغي أن يتجنب اختلاق بيانات عن مواعيد التسليم أو اقتراح حلول مرتفعة التكلفة دون معرفة حجم المتجر.
الاختبار الثاني: فهم الطلب السعودي
نص الاختبار: «عندي متجر، والطلبات صايرة تتأخر، والعميل كل شوي يسأل وين وصل طلبه. أبي أرتب الشغل من غير ما أوظف ناس زيادة». المطلوب: تحديد المشكلة وتقديم خطوات تنفيذية وكتابة رد مناسب للعميل السعودي. معيار المقارنة: هل يحافظ النموذج على المقصود نفسه، ويغير الأسلوب بما يناسب الجمهور، دون تعديل الحقائق أو اختراع معلومات؟
الاختبار الثالث: فهم المعنى الضمني
النص المصري: «العميل قال هيعدي علينا بعد العصر، بس مش عايز يلبس في طابور». النص الخليجي المقابل: «العميل بيجي بعد العصر، وما يبي ينتظر في طابور». المطلوب: شرح احتياج العميل، وتحديد إجراء بسيط لتقليل الانتظار. النتيجة المتوقعة: فهم أن العميل يريد الحضور واستلام الخدمة بسرعة، دون تفسير الكلمات بصورة حرفية غير مناسبة.
الاختبار الرابع: الالتزام باللهجة المطلوبة
يُطلب من النموذج كتابة رسالة اعتذار عن تأخر طلب، مرة باللهجة المصرية ومرة باللهجة السعودية. تُراجع النتيجة وفق ثلاثة معايير: طبيعية التعبير، وعدم الخلط الواضح بين اللهجتين، والمحافظة على رسالة الاعتذار دون وعود غير مؤكدة.
الاختبار الخامس: فهم نص مختلط بالعربية والإنجليزية
نص الاختبار: «الـorders متأخرة والـcustomer support مش لاحق يرد، وعايز workflow ينظم التذاكر». المطلوب: تحويل الطلب إلى خطة عمل عربية واضحة، مع توضيح المقصود بالمصطلحات الإنجليزية. هذا النوع من الرسائل مهم في بيئات التجارة الإلكترونية والتكنولوجيا، حيث يستخدم الموظفون والعملاء خليطًا من العربية والإنجليزية.
تاسعًا: بطاقة تقييم موحدة من 100 نقطة
يمكن استخدام الجدول التالي للمقارنة بين النماذج بعد تنفيذ الاختبارات فعليًا.
| المعيار | الوزن |
|---|---|
| فهم المعنى الأساسي | 30 |
| التعامل مع السياق والتعبيرات المحلية | 25 |
| الالتزام باللهجة المطلوبة | 20 |
| جودة الحل العملي | 15 |
| تجنب اختلاق المعلومات | 10 |
| الإجمالي | 100 |
ويفضل إجراء كل اختبار في محادثة جديدة، باستخدام التعليمات نفسها والإعدادات المتاحة قدر الإمكان. كما ينبغي تسجيل اسم النموذج وإصداره وتاريخ الاختبار، وإجراء مراجعة بشرية بواسطة أشخاص يعرفون اللهجة المستهدفة. لا يجوز نشر درجات أو ترتيب نهائي للنماذج إلا بعد تنفيذ التقييم وتوثيق نتائجه. هذا الإطار ليس معيارًا علميًا معتمدًا أو بديلًا عن الدراسات الأكاديمية؛ وإنما وسيلة تحريرية عملية للمقارنة داخل موقع AI-Dalil.
عاشرًا: كيف تختار النموذج المناسب لمشروع عربي؟
إذا كنت صانع محتوى، فإن أهم معيار قد يكون قدرة النموذج على الحفاظ على أسلوب اللهجة وطبيعية التعبير، وليس فقط تقديم نص صحيح نحويًا. أما إذا كنت صاحب متجر إلكتروني، فالأولوية ينبغي أن تكون لفهم نية العميل، والالتزام بسياسات المتجر، والقدرة على تقديم إجابات واضحة لا تتضمن وعودًا غير صحيحة. وبالنسبة إلى الشركات التي تستخدم وكلاء الذكاء الاصطناعي، تصبح إدارة الحالات الاستثنائية وتحويل المحادثة إلى موظف بشري عاملين مهمين.
وفي التعليم، قد يكون من الأنسب استخدام الفصحى في شرح المفاهيم والمصطلحات، مع السماح باللهجة المحلية لتبسيط الأمثلة عند الحاجة. لذلك لا توجد إجابة واحدة عن سؤال «ما أفضل نموذج للعربية؟»؛ بل توجد إجابات مختلفة حسب المهمة والجمهور ومستوى الدقة المطلوب.
هل يمكن تحسين فهم اللهجة من خلال كتابة الأوامر؟
يمكن تحسين وضوح طلب المستخدم بإضافة معلومات عن البلد والجمهور وطريقة الرد المطلوبة. فبدلًا من كتابة: «اكتب رد على العميل باللهجة الخليجية». يمكن تحديد المطلوب بصورة أكثر دقة: «اكتب ردًا قصيرًا لعميل سعودي يسأل عن تأخر طلبه. استخدم لغة سعودية طبيعية ومحترمة، ولا تختلق موعدًا للتسليم. إذا لم تكن حالة الشحنة متاحة، اطلب رقم الطلب للتحقق». هذه الصياغة لا تضمن الوصول إلى نتيجة مثالية، لكنها تقلل الالتباس وتوضح الحدود التي يجب على النموذج الالتزام بها.
وينطبق المبدأ نفسه على اللهجة المصرية، حيث يمكن تحديد نوع النشاط والجمهور وطبيعة العلاقة والدرجة المناسبة من الرسمية. والأفضل في التطبيقات المهنية توفير أمثلة حقيقية للردود المعتمدة داخل الشركة، بدل الاعتماد على طلب عام لتقليد اللهجة.
هل يؤثر ضعف فهم اللهجة في خدمة العملاء؟
نعم، يمكن أن يكون سوء فهم التعبيرات المحلية مشكلة عملية إذا أدى إلى تفسير خاطئ لطلب العميل. فعندما يقول شخص «الطلب واقف من امبارح»، قد يقصد أن حالة الطلب لم تتغير منذ اليوم السابق، وليس أن النظام توقف بالكامل. وإذا رد الوكيل بنصائح عامة عن أعطال الأنظمة دون التحقق من حالة الشحنة، فقد يفشل في حل المشكلة رغم أن لغته تبدو طبيعية.
ولهذا ينبغي اختبار وكلاء خدمة العملاء على محادثات مأخوذة من حالات واقعية بعد إزالة البيانات الشخصية، مع مراجعة الأخطاء التي قد تؤدي إلى تأخير الخدمة أو تقديم معلومات خاطئة. كما يفضل وضع آلية واضحة لتحويل المحادثة إلى موظف بشري عندما لا يفهم النظام الطلب أو لا تتوفر لديه البيانات اللازمة.
مستقبل الذكاء الاصطناعي العربي.. هل تتقلص الفجوة؟
تشير الدراسات الحديثة إلى زيادة الاهتمام بتطوير مجموعات بيانات ومعايير تقييم متخصصة للهجات العربية. ويمكن أن تساعد هذه الموارد الباحثين والشركات في فهم مواطن الضعف بدل الاعتماد على اختبارات الفصحى وحدها. لكن تقليص الفجوة يتطلب أكثر من إضافة كلمات محلية إلى بيانات التدريب؛ إذ يحتاج إلى تمثيل أوسع للمواقف اليومية، والتنوع الجغرافي، والفئات الاجتماعية، وطرق الكتابة المختلفة.
كما ينبغي أن تشمل الاختبارات النصوص والصوت والمحادثات متعددة الأدوار، لأن أداء النموذج في جملة قصيرة قد يختلف عن أدائه في حوار طويل مع عميل. وكلما أصبحت أدوات التقييم أكثر واقعية، أصبح بإمكان المستخدم العربي اتخاذ قرار مبني على نتائج قابلة للمقارنة، بدل الاكتفاء بالوعود التسويقية عن دعم اللغة العربية.
الأسئلة الشائعة
1. هل يفهم ChatGPT اللهجة المصرية؟
يدعم ChatGPT اللغة العربية رسميًا، ويمكن استخدام اللهجة المصرية في المحادثات معه. لكن مستوى الفهم الدقيق للتعبيرات المحلية يختلف حسب المهمة والسياق، ولا توجد في هذا التقرير نتيجة اختبار مباشر لأحدث إصدار. جرّب حالات من استخدامك الحقيقي، وراجع المقصود قبل تقييم طبيعية الصياغة.
2. هل يفهم Gemini اللهجة الخليجية؟
يدعم Gemini اللغة العربية، لكن تقييم فهم اللهجات الخليجية يتطلب اختبارات محددة للسعودية والإمارات والكويت وغيرها، ولا يكفي إعلان دعم العربية للحكم على جميع هذه الحالات. حدد الدولة والجمهور ونوع المحادثة، ثم راجع التعبيرات المحلية والمعنى المطلوب معًا.
3. ما الفرق بين دعم العربية ودعم اللهجات؟
دعم العربية قد يشير إلى فهم النصوص أو إنتاجها باللغة العربية، بينما يتطلب دعم اللهجات فهم التعبيرات المحلية والسياق الاجتماعي وطريقة الكلام الخاصة بكل منطقة. لذلك قد تكون الإجابة صحيحة بالفصحى، لكنها لا تناسب جمهور إعلان محلي أو محادثة خدمة عملاء.
4. هل النماذج العربية أفضل من ChatGPT وGemini؟
وجدت بعض الدراسات تفوق نماذج عربية متخصصة في مهام لهجية معينة، لكنها لا تثبت تفوق جميع النماذج العربية على أحدث النماذج العالمية في كل المجالات. تتعلق النتائج بالإصدارات والبيانات التي شملتها الدراسة، ويجب إعادة التقييم عند تغير النموذج أو المهمة.
5. هل توجد اختبارات علمية للهجات العربية؟
نعم، من بينها AraDiCE وDialectalArabicMMLU وEDRAC، وهي أبحاث تقيس جوانب مختلفة من فهم اللهجات وتوليد الإجابات والوعي الثقافي. وتختلف مهام هذه المعايير، لذا ينبغي قراءة المنهجية قبل مقارنة نتائجها أو تعميمها على منتج آخر.
6. لماذا يرد النموذج بالفصحى عندما أكلمه بالمصري؟
قد يفضل بعض النماذج الفصحى بسبب أنماط التدريب أو صياغة التعليمات أو طبيعة المهمة. ويمكن توضيح اللهجة المطلوبة وتقديم أمثلة، لكن ذلك لا يضمن الالتزام الكامل بها. حدد البلد ودرجة الرسمية وأرفق نموذجًا قصيرًا للرد المناسب، ثم راجع عدم خلط اللهجات.
7. هل يمكن استخدام الذكاء الاصطناعي لخدمة العملاء باللهجة السعودية؟
يمكن بناء حلول تعتمد على نماذج تدعم العربية، لكن يجب اختبارها على محادثات سعودية فعلية، والتحقق من دقة فهم الطلبات ومنع اختلاق المعلومات. ينبغي أيضًا ربط الرد بمعلومات المتجر الفعلية وتوفير تحويل لموظف عند غياب البيانات أو التباس الطلب.
8. هل تصلح النماذج الحالية لإعداد محتوى باللهجة المصرية؟
يمكن الاستفادة منها في إعداد المسودات والأفكار، لكن يفضل أن يراجع النص محرر يعرف اللهجة المصرية، خصوصًا في الإعلانات والسيناريوهات التي تعتمد على طبيعية الحوار. حدد شخصية المتحدث والجمهور وهدف النص، ثم عدّل التعابير غير الطبيعية قبل نشر المحتوى أو تسجيله.
الخلاصة: الذكاء الاصطناعي قد يتكلم بلهجتك دون أن يفهمك تمامًا
تكشف الأبحاث الحديثة أن فهم اللغة العربية لم يعد تحديًا واحدًا، بل مجموعة من التحديات المرتبطة باللهجات والسياقات الثقافية ونوع المهمة. وقد يستطيع نموذج كتابة جملة باللهجة المصرية أو السعودية بصورة تبدو طبيعية، بينما يخطئ في تفسير المقصود أو يقدم استجابة لا تناسب الموقف. ولهذا فإن السؤال الأهم للمستخدم العربي ليس ما إذا كان ChatGPT أو Gemini يستطيعان كتابة كلمات محلية، بل ما إذا كانا يفهمان احتياجاته وينفذان المهمة المطلوبة بدقة.
وتوضح الدراسات المنشورة في 2025 و2026 أن المجال يتقدم، لكنه لا يزال بحاجة إلى اختبارات أكثر تمثيلًا للتنوع العربي. وفي AI-Dalil، نرى أن الاختبار الحقيقي لأي مساعد ذكي يبدأ عندما يفهم كلام المستخدم كما يقصده، لا عندما ينجح فقط في تقليد لهجته.
المصادر العلمية والرسمية
تخص نتائج الأبحاث النماذج والمهام والإصدارات التي شملتها كل دراسة، ولا تمثل اختبارًا مباشرًا أجراه دليل AI لأحدث إصدارات المنتجات. إطار الحالات الخمس وبطاقة التقييم مساهمة تحريرية مقترحة، وليسا ترتيبًا فعليًا للنماذج.
لا تعليقات بعد — كن أول من يشارك رأيه.